DelayQ:用 Redis 和数据库做一个延时队列
业务里总有一类需求,叫“过一会儿再做”。
订单创建后 30 分钟没付款就自动关单;下单 15 分钟后推一条提醒;接口调失败了,等 5 分钟再重试一次;会员到期前三天发一封续费通知。
这类需求拆开看,目标都很朴素:到点执行、失败了要能重试、最后还得看得见状态。难点从来不在“延”,而在“时”—— 谁来记着这件事,以及进程重启之后它还记得吗。
DelayQ 就是我为这件事写的一个中间件。
先说为什么不用现成的
最省事的做法是在业务代码里 Thread.sleep(),或者丢给 ScheduledExecutorService。单机跑个小脚本没问题,可它撑不住两件事:进程一重启,内存里的任务就全没了;多起一个实例,两边各算各的。
换成定时任务扫库呢?那得先回答两个问题:多久扫一次 —— 扫得越勤精度越高、数据库压力也越大;以及怎么保证几个实例不会同时抢到同一个任务。这两个问题不难,但每次都要重新想一遍。
那上 MQ 呢?RabbitMQ 用 TTL + 死信队列能做延时,RocketMQ 有自带的延时消息。都是成熟方案,但它们的延时级别往往是固定的几档,而且通常还附带一整套运维成本。我需要的是“任意秒数 + 到点调一个 HTTP 接口”,为这一件事养一个 MQ,不太划算。
DelayQ 的设计参考了有赞延迟队列的思路:把“任务的元信息”和“待触发的时间线”拆开存,中间用一条扫描线连接。
它是什么
一句话:基于 Redis 和数据库的延时队列中间件,Java 开发,到点之后去调用一个你指定的 RESTful 接口。
跑起来之后是这样的:
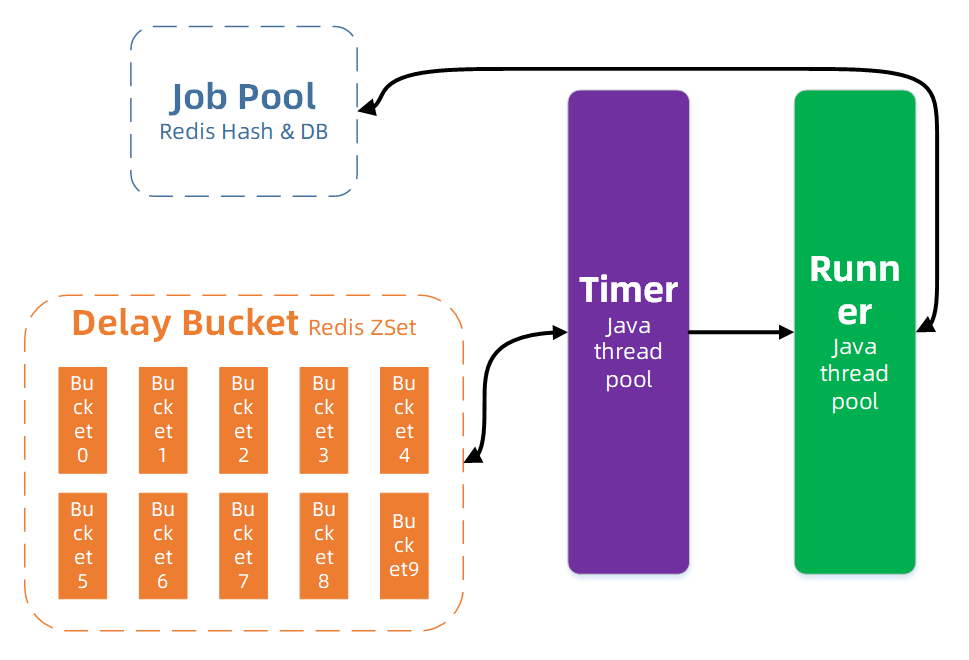
四块职责:
- Job Pool —— 存放所有 Job 的元信息,落在 Redis Hash 和数据库里;
- Delay Bucket —— 十组以时间为维度的有序队列(Redis ZSet),按 Job Id 判定存进哪个 Bucket,里面只放 Job Id;
- Timer —— 实时扫描各个 Bucket,把 delay 时间已经到期的 Job 丢进对应的 Ready Queue;
- Ready Queue —— 按任务类型(Topic)执行,执行完把任务状态回写进 Job Pool。它对应架构图右侧那个 Runner。
这里有个刻意的分工:用 Redis ZSet 存时间线,“找下一个该执行的任务”就是一次有序查询,不用把整个队列翻一遍;而真正的任务体(要调的 URL、header、body)放在 Job Pool 里,Bucket 里只留一个 Id。高频变动的那个结构因此始终很轻。
它不假装自己是通用 MQ
先把边界说清楚,省得你跑起来才发现不对路。
DelayQ 只做一件事:到点了,替你去调一个 HTTP 接口。
- 目前只支持 Post 请求,其他请求方式还在计划里;
- 数据库是用 PostgreSQL 开发的,理论上兼容 Oracle、MySQL、MariaDB,但这个“理论上”需要你自己验一遍;
- 它依赖 Redis 和一个数据库,不是一个零依赖的独立进程;
- 它不做消息的广播、分区、顺序保证,那些是 MQ 的活儿。
三个真正用得上的细节
delay 和 ttr
创建任务时有三个参数:topic 是任务类型,delay 是从现在起等多少秒再执行,ttr 是超时时间,单位都是秒。
passrule:怎么判断“成功了”
调远端接口最麻烦的是“它到底成没成”。HTTP 200 不代表业务成功,返回体里可能明明白白写着 "code": 0。
DelayQ 的做法是让你给一条通过规则:
"passrule": { "code": "1" }
它拿远端服务返回的报文去比这条规则,对上了才算任务成功。比只看 HTTP 状态码靠谱得多 —— 任务状态是 success 还是 error,得由业务结果说了算。
任务是看得见的
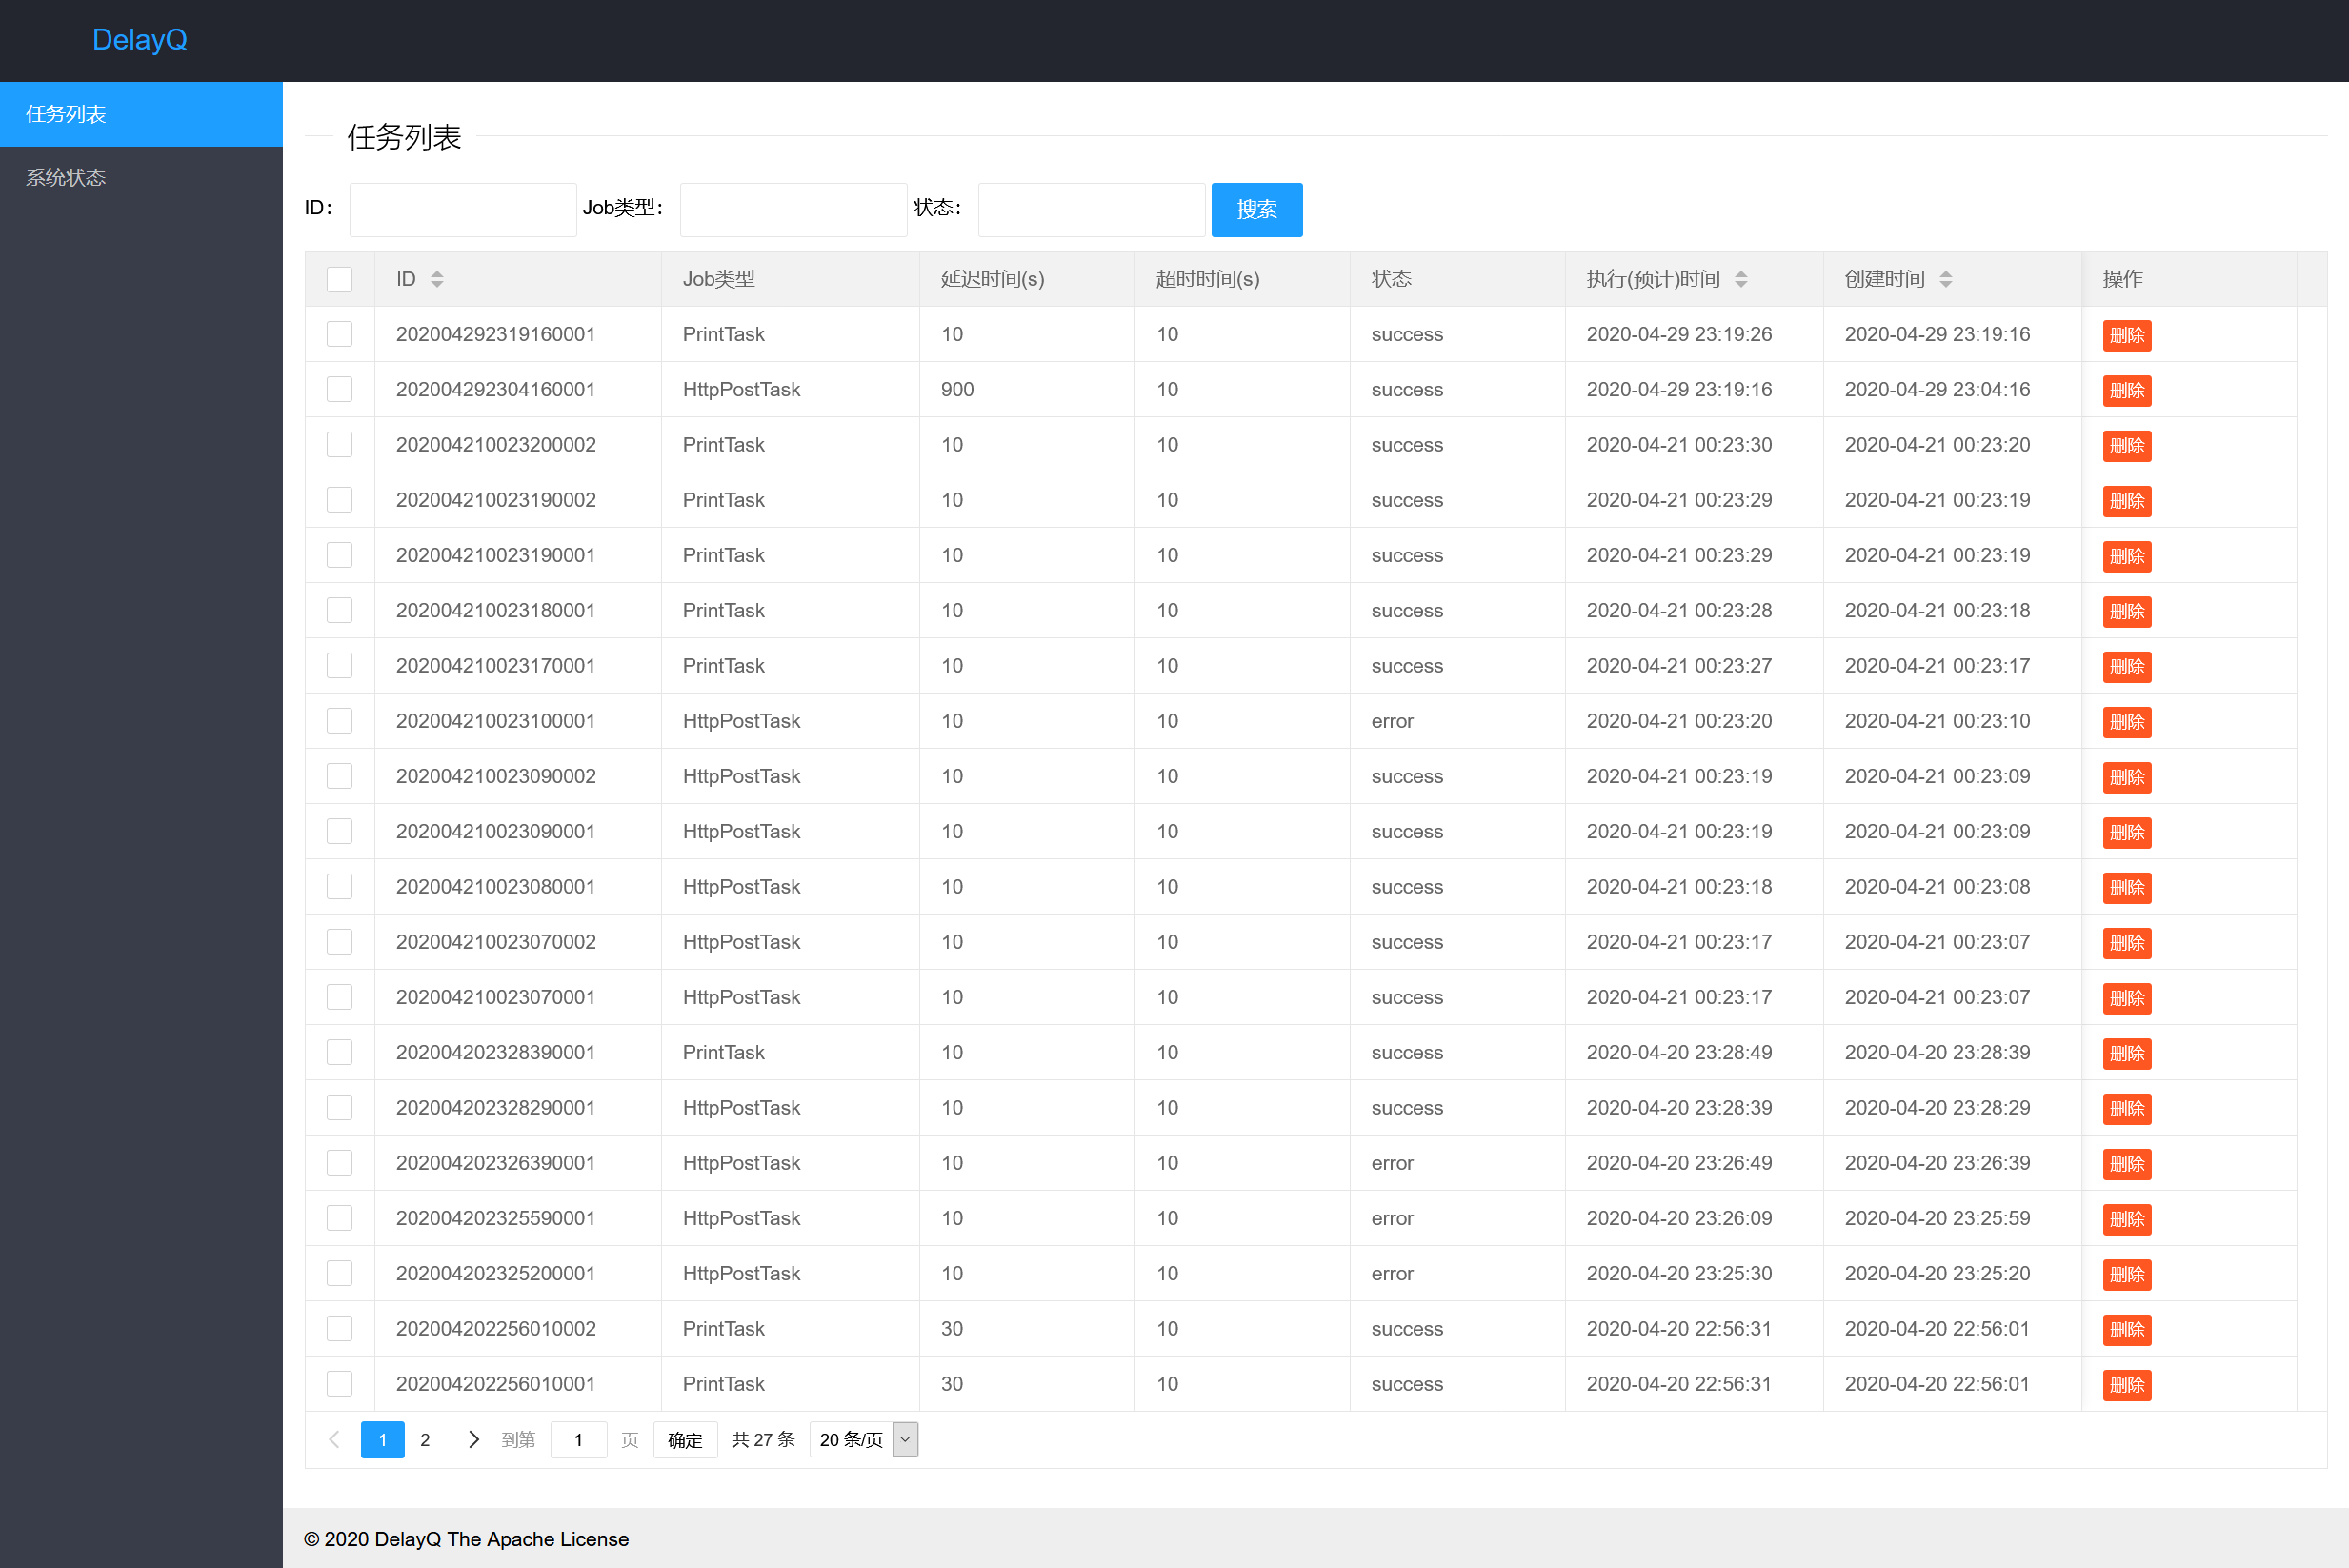
列表页把每个 Job 的类型、delay、ttr、状态(success / error)、预计执行时间和创建时间都摆了出来,顶部可以按 ID、Job 类型、状态筛选。排查的时候不至于去翻日志猜 —— 这一点在我自己的使用里比想象中重要。
跑起来
环境只要三样:Java 1.8+、Redis、一个数据库。
1. 建表。 仓库里给了 PostgreSQL 和 Oracle 两份 DDL,PostgreSQL 这份是:
CREATE TABLE tb_delayq_job (
    id int8 NOT NULL,
    topic varchar(50) NULL,
    delay int4 NULL,
    ttr int4 NULL,
    body varchar(1000) NULL,
    status varchar(10) NULL,
    execution_time int8 NULL,
    create_time int8 NULL,
    CONSTRAINT pk_tb_delayq_job_id PRIMARY KEY (id)
);
2. 改配置。 编辑 application-dev.yml,填上 Redis 和数据库的连接信息。
3. 启动。
./startup.sh
或者直接跑 jar:
java -jar DelayQ.jar --spring.profiles.active=dev
4. 打开界面。 访问 http://localhost:16996/delay-q/index,就是上面那个任务列表。
加一个任务
向 add 接口发一个 Post,查询参数就是前面说的三个:
POST http://localhost:16996/delay-q/add?topic=HttpPostTask&delay=60&ttr=10
请求体里写清楚“到点之后要干什么”:
{
  "url": "http://172.16.6.202:16996/delay-q/add?topic=PrintTask&delay=10&ttr=10",
  "headers": {
    "Content-Type": "application/json"
  },
  "body": "",
  "passrule": {
    "code": "1"
  }
}
参数逐个说:
topic(必填):任务类型,HttpPostTask是内置的那一种;delay(必填):等待秒数;ttr(必填):超时秒数;url(必填):远端服务地址;headers(可选):请求头;body(可选):POST 的报文;passrule(可选):上面那条通过规则。
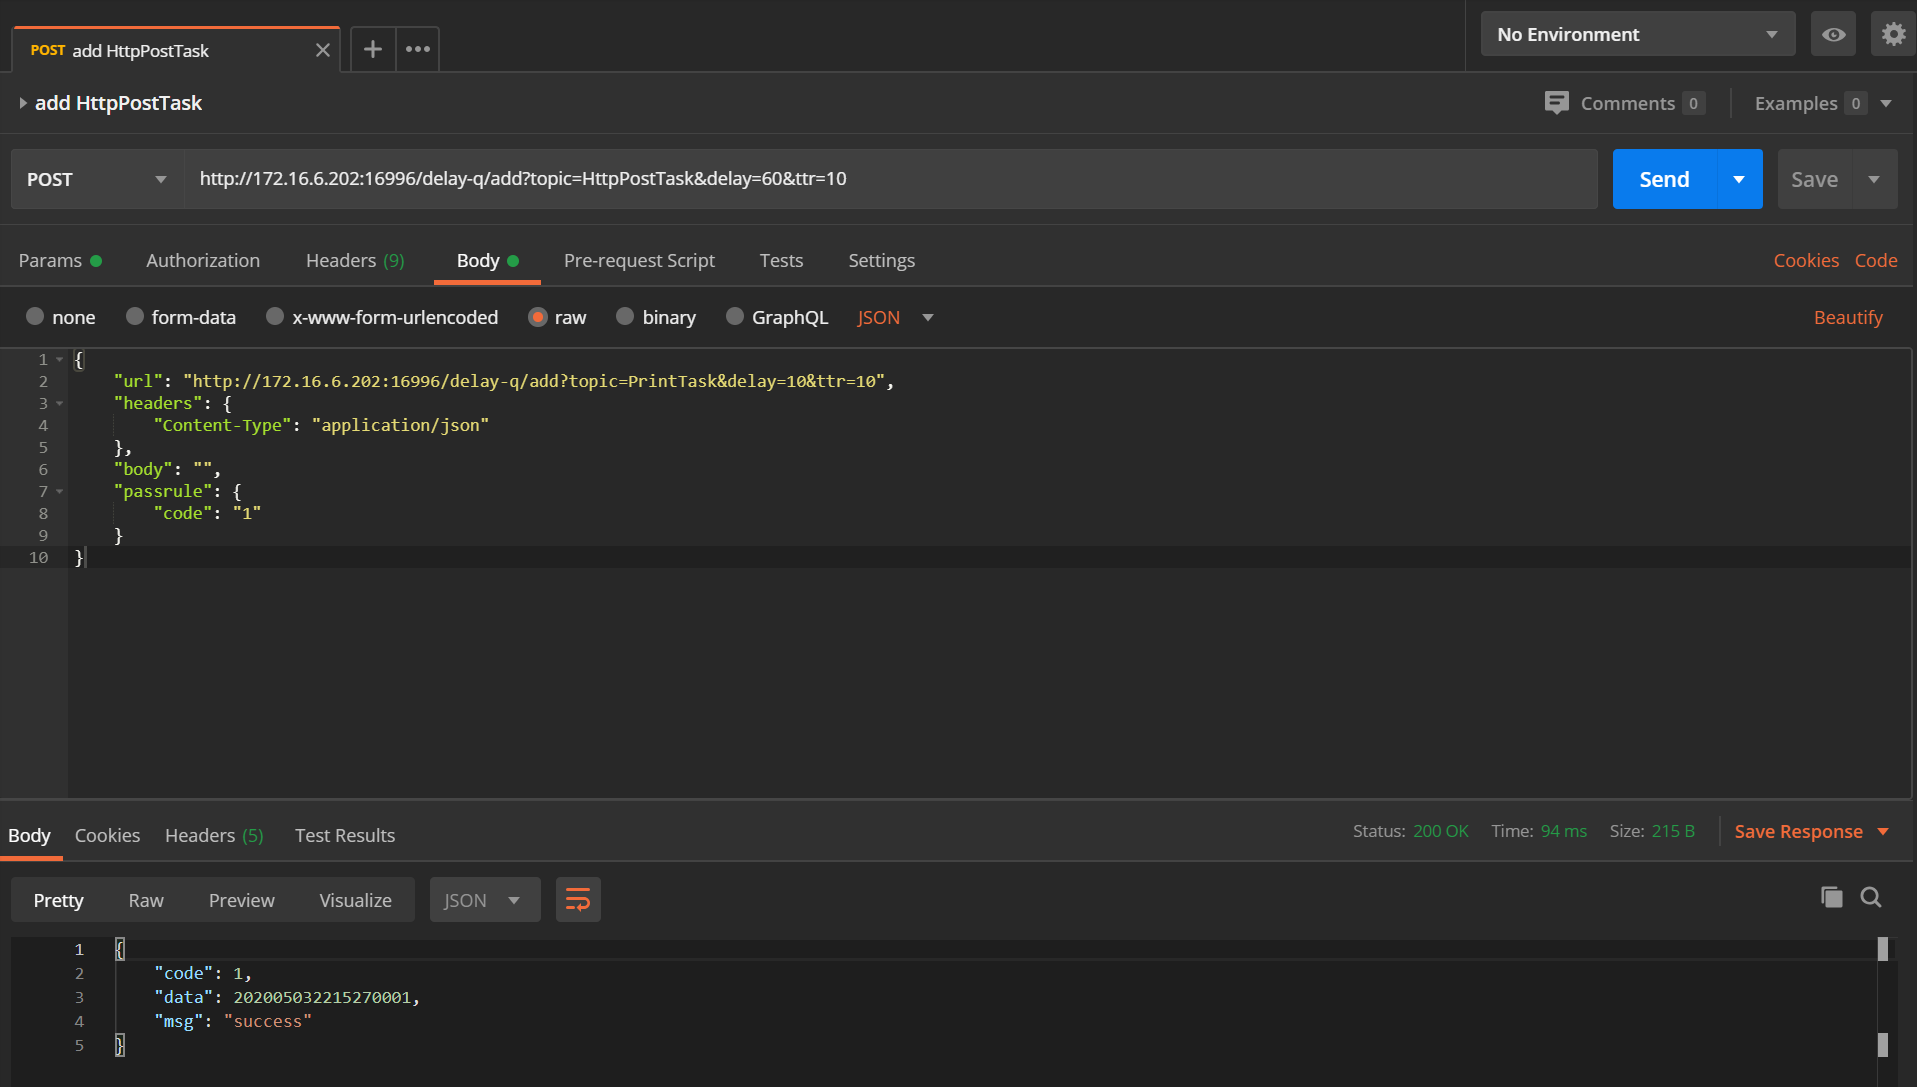
返回体里的 data 就是新建 Job 的 ID,拿它去列表页就能查到这条任务后面执行成什么样了。
现在的样子,和下一步
它还算年轻,有几件事我自己清楚没做好,一并写在这里:
- 多实例部署时,多个 Timer 会同时扫描。 同一批 Bucket 被重复扫,白白消耗资源 —— 这是最该先解决的问题;
- 只支持 Post。 后续想加上更多请求方式;
- 界面功能还薄。 列表、筛选、删除够用,但离完善还有距离。
最后
仓库在这里,Apache License 2.0,代码随便看、随便用:
如果你也在纠结“这几万个到点要执行的任务该放哪儿”,可以先 clone 下来跑一遍 —— 建一张表、连上 Redis,就能看到任务在列表里一条条变成 success。
用着有问题或者有想法,欢迎直接提 Issue。